Как создать цифровой архив сайтов
Есть разные способы сохранения копии сайта: готовые онлайн-сервисы и приложения, а также утилиты командной строки (CLI).
🚨 Экстренная ситуация? Если времени мало, используйте Быстрый старт: архивация за 5 минут или перейдите к разделу Экстренные сценарии ниже.
Быстрое сохранение отдельных страниц
Для сохранения одной или нескольких веб-страниц можно использовать онлайн-сервисы:
Метод 1: Archive.org (Internet Archive)
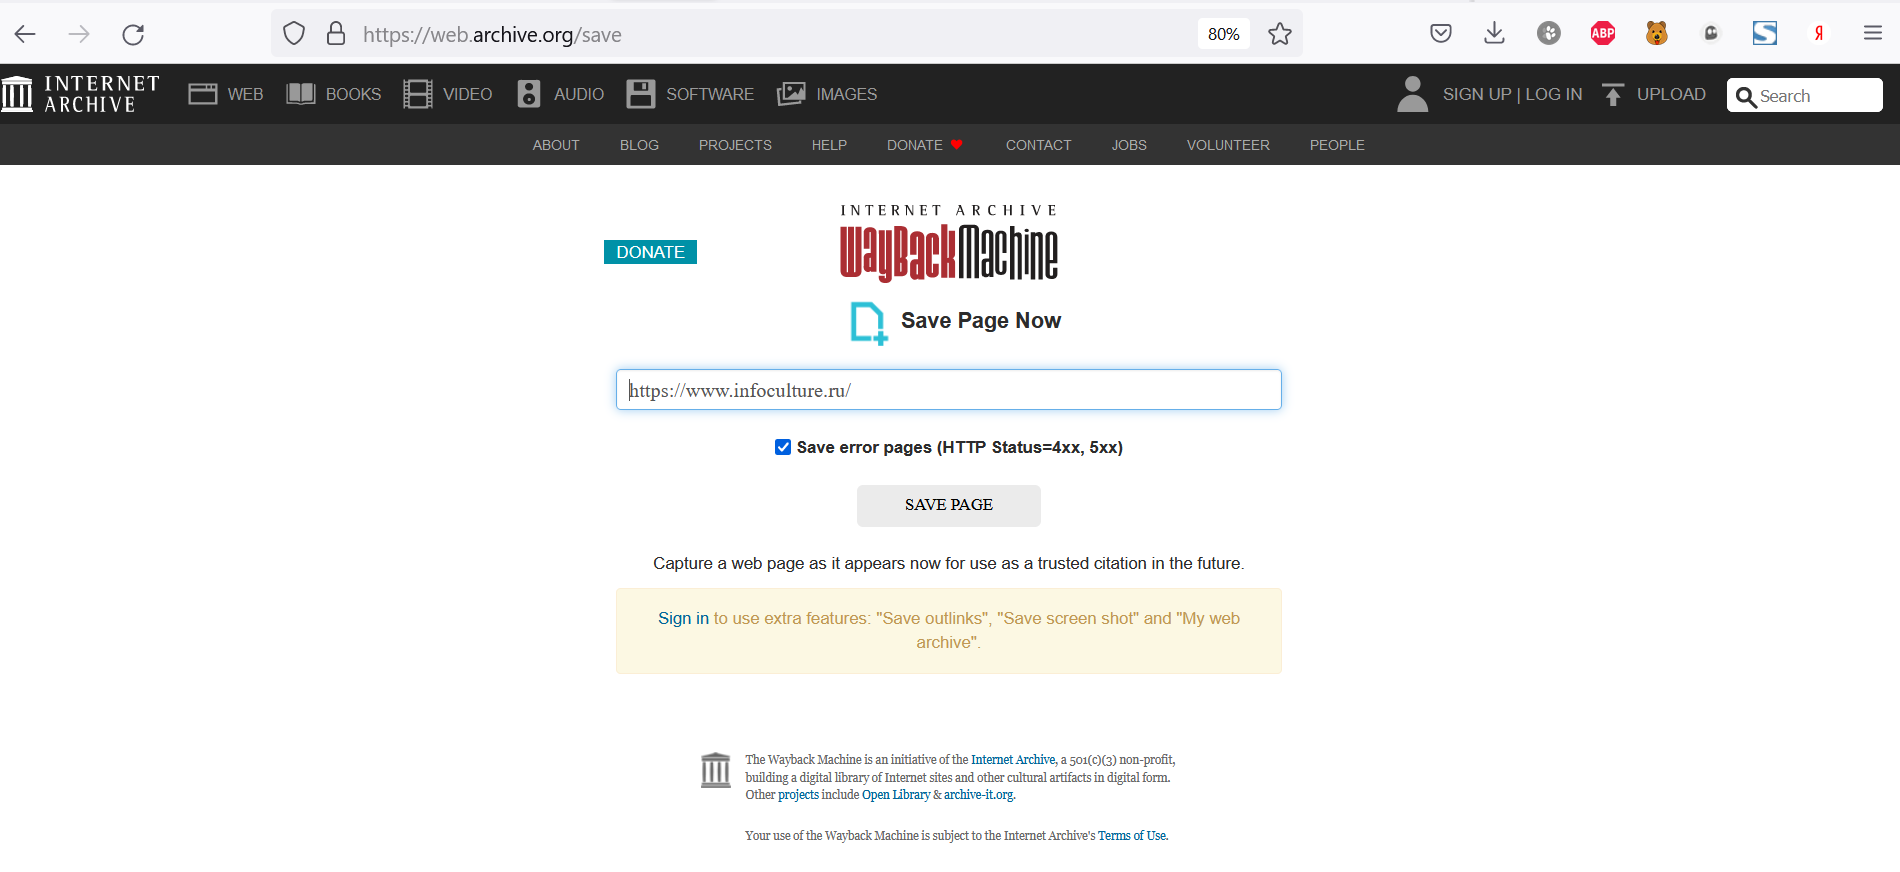
Сохранить страницу можно через форму Save Page Now Интернет Архива на этой странице. Пошагово:
- Перейдите по ссылке: https://archive.org/web/.
- Вставьте URL-адрес страницы, которую вы хотите заархивировать, в поле Save Page Now (внизу справа).
- Нажмите на кнопку сохранения страницы (или клавишу Enter).
- Подождите, пока страница будет обработана. После завершения появится URL-адрес заархивированной копии.
Метод 2: Archive Today (archive.ph)
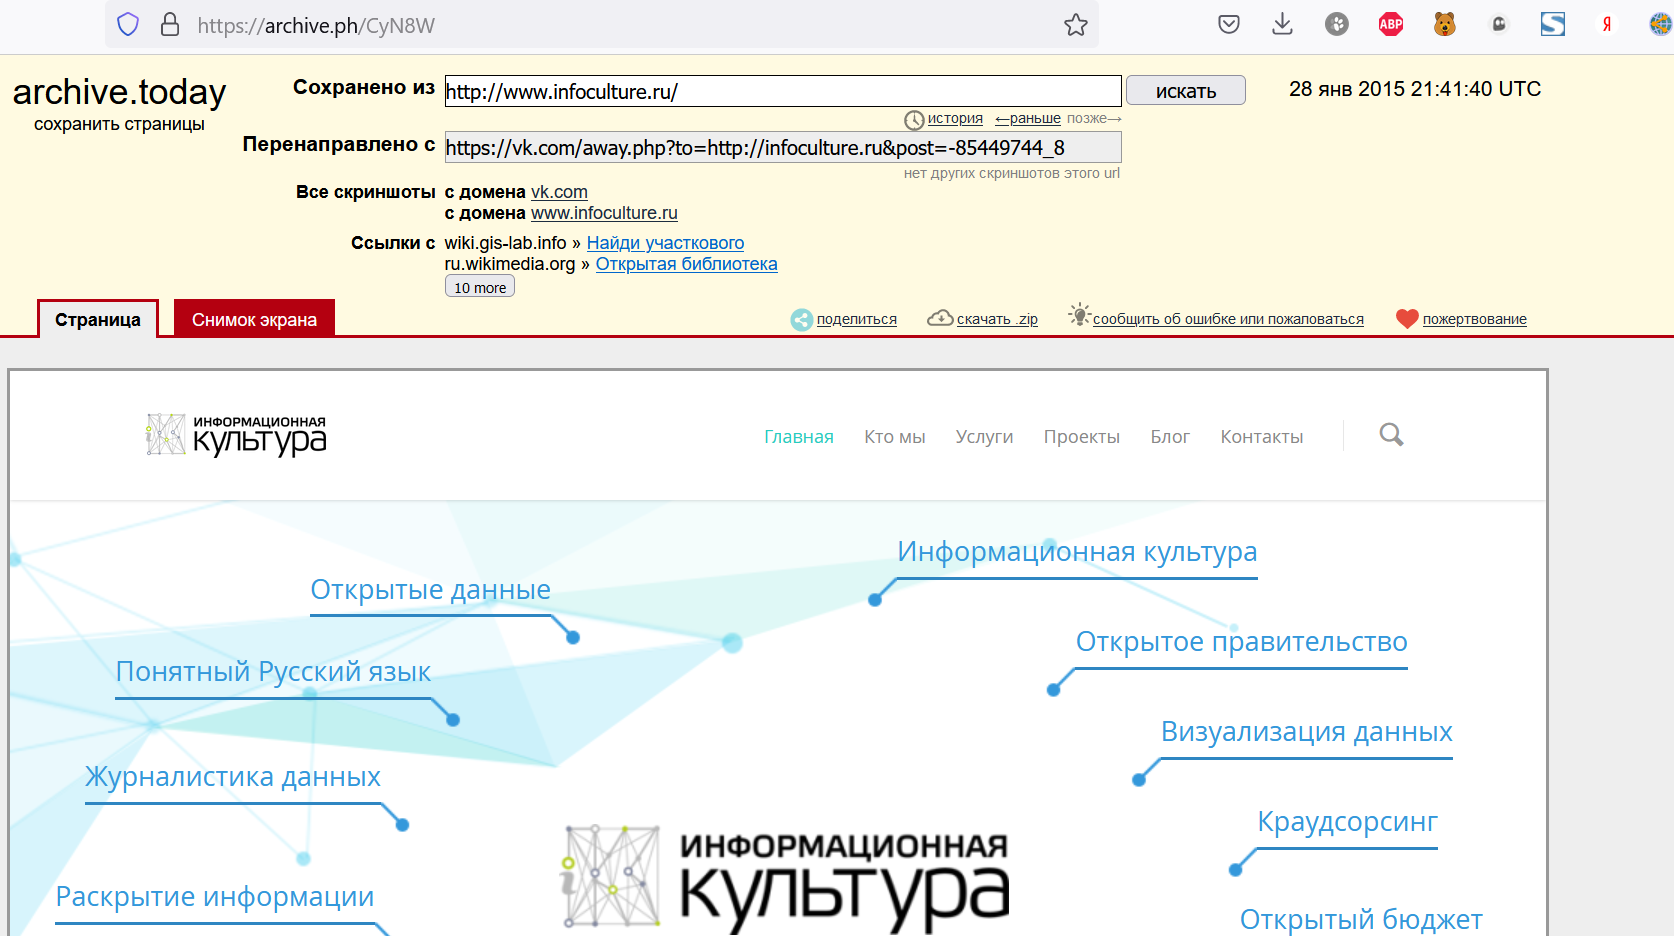
Сервис сохраняет текстовую и графическую копии веб-страницы и даёт ссылку на снимок. Используйте его только как дополнительную копию к Save Page Now: в 2026 году оператор archive.today менял сохранённые снимки (подробнее).
На главной странице сервиса можно ввести ссылку на веб-страницу, и она будет сохранена. Для сохранения страниц прямо из браузера есть расширение для Firefox.
Примечание: эти методы подходят для отдельных страниц или небольших сайтов, а файл архива (WARC) вы на руки не получаете. Для полной архивации сайта используйте инструменты, описанные ниже.
Сравнение инструментов: что выбрать?
| Инструмент | Скорость | Сложность | Файл WARC/WACZ | Когда использовать |
|---|---|---|---|---|
| Save Page Now | ⚡⚡⚡ минуты | ★☆☆ | Нет (копия хранится в Wayback Machine) | Одна страница, срочно, без установки |
| Archive.ph | ⚡⚡⚡ минуты | ★☆☆ | Нет | Только дополнительная копия к Save Page Now |
| HTTrack | ⚡⚡ часы | ★★☆ | С версии 3.49-14, --warc | Локальная копия для просмотра, есть GUI |
| Wget | ⚡⚡ часы | ★★★ | Да, --warc-file | Автоматизация, тонкая настройка |
| Wpull | ⚡⚡ часы | ★★★ | Да | Wget-совместимый краулер на Python; не развивается |
| Browsertrix | ⚡ дольше | ★★☆ | Да, WARC и WACZ | Сайты на JavaScript, интерактивность |
Быстрый выбор:
- 📄 Одна статья или страница → Save Page Now; Archive.ph — только как дополнительная копия
- 🏠 Небольшой сайт (до 1000 страниц) → Wget с WARC; HTTrack, если нужна только локальная копия
- 🏢 Большой или сложный сайт → Wget или Browsertrix
- ⚡ Экстренно → Save Page Now и экстренные сценарии
Экстренные сценарии
Когда счёт идёт на минуты
Если сайт может быть заблокирован или удалён в ближайшее время:
1. Первые минуты — сохраните главные страницы через Save Page Now:
Откройте web.archive.org/save и сохраните:
- главную страницу;
- страницу «О нас» / «About»;
- ключевые статьи и материалы;
- страницу контактов.
Дополнительно можно сохранить те же страницы в archive.ph, но не как единственную копию. Подробнее: Wayback API и Save Page Now, Archive.ph
2. Следующие минуты — запустите быструю архивацию всего сайта с записью WARC:
wget --recursive --level=inf --page-requisites --adjust-extension --convert-links \
     --no-parent --wait=0.5 --limit-rate=200k \
     --warc-file=site-to-save --warc-cdx \
     https://site-to-save.com/
Рядом с локальным зеркалом появятся site-to-save.warc.gz и CDX-индекс. Именно WARC пригоден для веб-архива и просмотра в pywb или ReplayWeb.page; --convert-links меняет только локальные файлы, в WARC сохраняются исходные ответы. Вместо --recursive --level=inf можно написать --mirror, но с WARC wget отключает включённую в него проверку временных меток и выводит об этом предупреждение.
⚠️ Важно: эта команда может пропустить контент, который подгружается JavaScript. Для полноты используйте детальную настройку из руководства по wget или Browsertrix.
3. Если есть час-два:
Запустите Browsertrix для сайтов с JavaScript или HTTrack, если нужна только локальная копия для просмотра (см. раздел HTTrack ниже).
Полный гайд по экстренной архивации: Экстренная архивация: когда счёт идёт на часы
HTTrack
HTTrack — бесплатное (GPL) и простое в использовании приложение, которое загружает веб-сайт в локальный каталог: HTML-код страниц, изображения и другие файлы. Есть режим рекурсивной выгрузки всех страниц.
HTTrack сохраняет относительную структуру ссылок исходного сайта, так что копию можно открыть в браузере. Приложение имеет графический интерфейс и работает под Windows, macOS и Linux. Начиная с версии 3.49-14 (2026) HTTrack умеет писать WARC/1.1 и WACZ (-%r/--warc, --warc-cdx, --wacz); в более старых версиях WARC нет, и для веб-архива лучше подходят wget или Browsertrix. Подробнее — на странице HTTrack.
Для использования приложения не нужна специальная подготовка, но оно работает и из командной строки (руководство пользователя). Подробнее — на странице HTTrack.
Утилиты командной строки (CLI)
Классические утилиты командной строки для создания архива сайта — Wget и Wpull.
Wget
Wget — свободная программа для получения файлов по HTTP, HTTPS и FTP. Это неинтерактивный инструмент командной строки, поэтому его легко вызывать из скриптов и терминала.
Возможности, полезные для зеркалирования сайтов:
- возобновление прерванной загрузки;
- рекурсивное зеркалирование каталогов;
- преобразование ссылок в загруженных документах в относительные, чтобы копию можно было открыть локально;
- поддержка cookies и постоянных HTTP-соединений;
- работа в фоновом режиме;
- запись WARC (
--warc-file) начиная с версии 1.14.
Wget распространяется под лицензией GNU General Public License. Подробнее — Использование утилиты wget.
Wpull
Wpull — Wget-совместимый веб-загрузчик и краулер на Python с записью WARC. Краулер систематически обходит страницы сайта по ссылкам и сохраняет их.
Последний выпуск wpull на PyPI — 2.0.1 (2016 год); встроенная интеграция с PhantomJS устарела, поскольку сам PhantomJS больше не развивается. Для новых проектов чаще используют grab-site, который построен на форке wpull. Подробнее — на странице Wpull.

У этих утилит есть режим рекурсивной выгрузки всех страниц, он задаётся опцией -r. В самом простом варианте достаточно выполнить команду, подобную этой:
wget -r -l inf --page-requisites --no-parent \
     --warc-file=example --wait=1 \
     https://example.com/
Дальнейшие шаги
После успешной архивации сайта:
- Проверьте результат: откройте WARC в ReplayWeb.page или сохранённые файлы в браузере.
- Создайте резервную копию: скопируйте архив в несколько мест.
- Изучите продвинутые техники: Полное руководство по wget.
- Узнайте о форматах: WARC и WACZ.
Связанные материалы
- Быстрый старт: архивация за 5 минут — для начинающих
- Archive.ph: полное руководство — архивация отдельных страниц
- Экстренная архивация — когда счёт идёт на часы
- Использование утилиты wget — подробно о командной строке
- Справочник форматов — WARC, WACZ и другие